Cursusmateriaal ontwikkelen met AI
Hoe “Hoe toestellen praten” in één maand tot stand kwam
Ward De Ridder — graduaat IoT, OLOD Netwerken
Toegegeven: ook deze slides zijn AI-gegenereerd
“Er is mij gevraagd om een kleine presentatie te maken over cursusmateriaalontwikkeling met behulp van AI. Ik wil daar mijn proces tonen om de cursus netwerken te maken. Kan je hier een paar slides van maken? De slides komen in ../cursus, en daar is ook veel AI in gekropen om deze in orde te maken, kijk zeker in de git history. Slides die je maakt mogen in een nieuwe content map AP. Maak de slides zo fancy mogelijk, je ziet mogelijkheden in sjabloon. Bekijk ook de git history van de repo waar we nu inzitten, daar is ook veel gebeurd (moodle export / pipeline van MD naar vanalles, contentontwikkeling, ….) Maak je hier iets mooi van? Als je vragen hebt stel ze gerust. Als je nog iets terugvind in oude geschiedenis (maar ik zie het niet meer staan) zeker ook doen! Vermeld ook dat ik meerdere keren het boek of stukken van het boek in andere AI’s heb gestoken, en gevraagd heb het heel kritisch na te lezen, en beweringen te verifiëren.”
Wat de AI deed
beide git-histories doorgelezen, cijfers geteld, screenshots gemaakt, dit deck geschreven en zelf nagekeken
Wat ik deed
die ene vraag stellen, nalezen, de conclusie en de tijdlijn toevoegen — en dit erbij zetten
Wat ligt er vandaag op tafel?
8
hoofdstukken
47.500 woorden, 218 pagina’s A4
208 slides
6 decks, 186 speakernotes
Moodle
boek, slides en 80 zelftestvragen per import
1 bron
markdown in git → alles wordt gegenereerd
Van 23 juni tot 23 juli 2026. Daarvoor: handgemaakte slides zonder cursustekst. Daarna: een boek, nieuwe slides, een Moodle-cursus en een pipeline die alles opnieuw kan bouwen.
Eén maand in vogelvlucht
23 jun
eerste opzet: hoofdstuk 1 en 2 uit de ECTS-fiche
25 jun
alle 8 hoofdstukken in ruwe vorm
28 jun
PDF-pipeline: pandoc, XeLaTeX, register
3 jul
feitencheck door andere AI’s, correcties
17 jul
slides uit het boek + CI-deploy
18 jul
Moodle-import volledig gegenereerd
21 jul
huisstijl-sjabloon, alle decks gemigreerd
Agenda
1
Het boek — van ECTS-fiche tot 218 pagina’s
2
Kritisch tegenlezen — AI verifieert AI
3
De pipeline — van markdown naar alles
4
Slides en huisstijl
5
Moodle — een cursus als build-artefact
6
Werkwijze en lessen
1. Het boek
Van ECTS-fiche tot 218 pagina’s
Vertrekpunt: de ECTS-fiche als contract
🎯 Doelgroep
de grens tussen elektricien en IT’er: installateurs van laadpalen, camera’s, gebouwautomatisering
📋 Leerdoelen
13 OLR-leerdoelen in 5 clusters, letterlijk overgenomen
📚 Leerinhoud
OSI/TCP-IP, adressering, NAT, firewalls, Wireshark, troubleshooting
✅ Toetsing
digitaal, subnetting + Wireshark
Dit alles staat in de README van de repo — dat bestand is de briefing voor élke AI-sessie: wie de student is, wat er in moet, welke toon past.
De eerste opzet: 23 juni
Briefing
README + ECTS + oude slides
→
AI schrijft
hoofdstuk 1: 666 regels in één commit
→
Ik lees
“volgorde verbeteren”, “betere IoT-introductie”
→
Commit
kleine stappen, elke stap in git
Op dag één al 7 afbeeldingen weggegooid wegens copyright. Sindsdien: enkel zelfgemaakte SVG’s, Mermaid-diagrammen en zelf gegenereerde illustraties.
Drie dagen later: acht hoofdstukken
Breedte ≈ aantal woorden per hoofdstuk (H2 is met 10.700 woorden het grootste, H5 met 3.400 het kleinste)
3 dagen
voor de ruwe versie
4 weken
nalezen, verifiëren, verfijnen
De mens stuurt: wat ik zelf besliste
Toon
“verder generaliseren naar techniekers” · “inhoud iets minder IoT-focussed”
Voorbeelden
“ont-AP-en”:
ap.be → wikipedia.org · laadpaal als lichte rode draad, maar variatie behoudenDiepgang
“hs1 nog eens kritisch nagelezen” · “herwerken hs3” · “aanvullen modbus / vpn”
Elk hoofdstuk is minstens twee keer volledig door mij gelezen. De AI schrijft snel; de richting, de doelgroep en de toon blijven een menselijke keuze.
2. Kritisch tegenlezen
AI verifieert AI
Het boek in andere AI’s steken
Meerdere keren het hele boek, of stukken ervan, in een ander AI-model gestoken met de opdracht: lees dit heel kritisch na en verifieer elke bewering.
Waarom een ander model?
- een model leest zijn eigen tekst te welwillend
- een frisse lezer zonder de context van het gesprek
- andere trainingsdata = andere blinde vlekken
Wat kwam eruit?
- feitelijke fouten die vlot en overtuigend klonken
- verschoven tabellen, verkeerde registers
- logische redeneringen die niet klopten
Wat deed ik ermee?
- elke opmerking zelf beoordeeld
- verifiëren tegen bron of eigen systeem
- pas dan als kleine, aparte commit verwerkt
Wat het tegenlezen opleverde
Wireshark-kleuren
tabel was één rij verschoven: groen is HTTP, niet TCP — geverifieerd tegen
/usr/share/wireshark/colorfiltersModbus-register
40001 → 30001 (Input Register, functiecode 04); adresbereiken expliciet gemaakt
.io is geen gTLD
het is de ccTLD van het Brits Indische Oceaanterritorium; vervangen door
.techGateway-redenering
“ping 8.8.8.8 lukt → gatewayprobleem” is logisch onmogelijk; stap herschreven
Wi-Fi 7
320 MHz-kanalen ontbraken in de kanaalbreedtetabel
Tijd
3G-uitfasering stond in de toekomende tijd; duplex mismatch-nuance toegevoegd
Waar de AI zélf de mist in ging
Zoek-en-vervang
“Wi-Fi overal correct geschreven” brak
nmcli dev wifi list tot nmcli dev Wi-Fi list — pas weken later gevondenBeeldmateriaal
eerste versie bevatte foto’s van het web; dag één allemaal weg
Twee keer vragen
“woordafbreking ontmoedigen” (penalty 9000) was niet genoeg; pas “volledig uit” na een tweede opmerking
Les: automatische wijzigingen over het hele boek zijn precies de plek waar je codeblokken en commando’s daarna opnieuw moet controleren.
3. De pipeline
Van markdown naar alles
Eén bron, vijf uitvoerformaten
flowchart LR
MD["Markdown
hs1 … hs8"] --> PRE["preprocess.py
mermaid → PDF, SVG → PDF,
indextermen injecteren"] PRE --> PANDOC["pandoc + Lua-filter
callout-kaders"] PANDOC --> TEX["XeLaTeX
Eisvogel-sjabloon"] TEX --> A4["Boek A4 + B5"] TEX --> HS["PDF per hoofdstuk"] PRE --> BOOK["Moodle-boek
(HTML per sectie)"] MD -. "boek_commit" .-> SL["Slides
reveal.js via Hugo"] SL --> SITE["Website + slides.pdf"] SITE --> MBZ["Moodle-import
.mbz"] BOOK --> MBZ HS --> MBZ
Wat de AI hier allemaal oploste
Docker
build-omgeving op pandoc/extra met mmdc, Chromium, librsvg — reproduceerbaar zonder lokale installaties
Paginabreuken
needspace op koppen én tabellen, geschat op cellengte, zodat kop + tabel samen springen
Register
imakeidx i.p.v. makeidx: correct paginanummer, “Trefwoordenregister” in inhoud en voettekst
Vector
mermaid en SVG als PDF ingesloten, met pdfcrop — geen wazige rasterafbeeldingen meer
Formaten
A4 en B5 tweezijdig uit dezelfde bron, hoofdstuk-PDF’s met eigen titelblad
Zo ziet het resultaat eruit
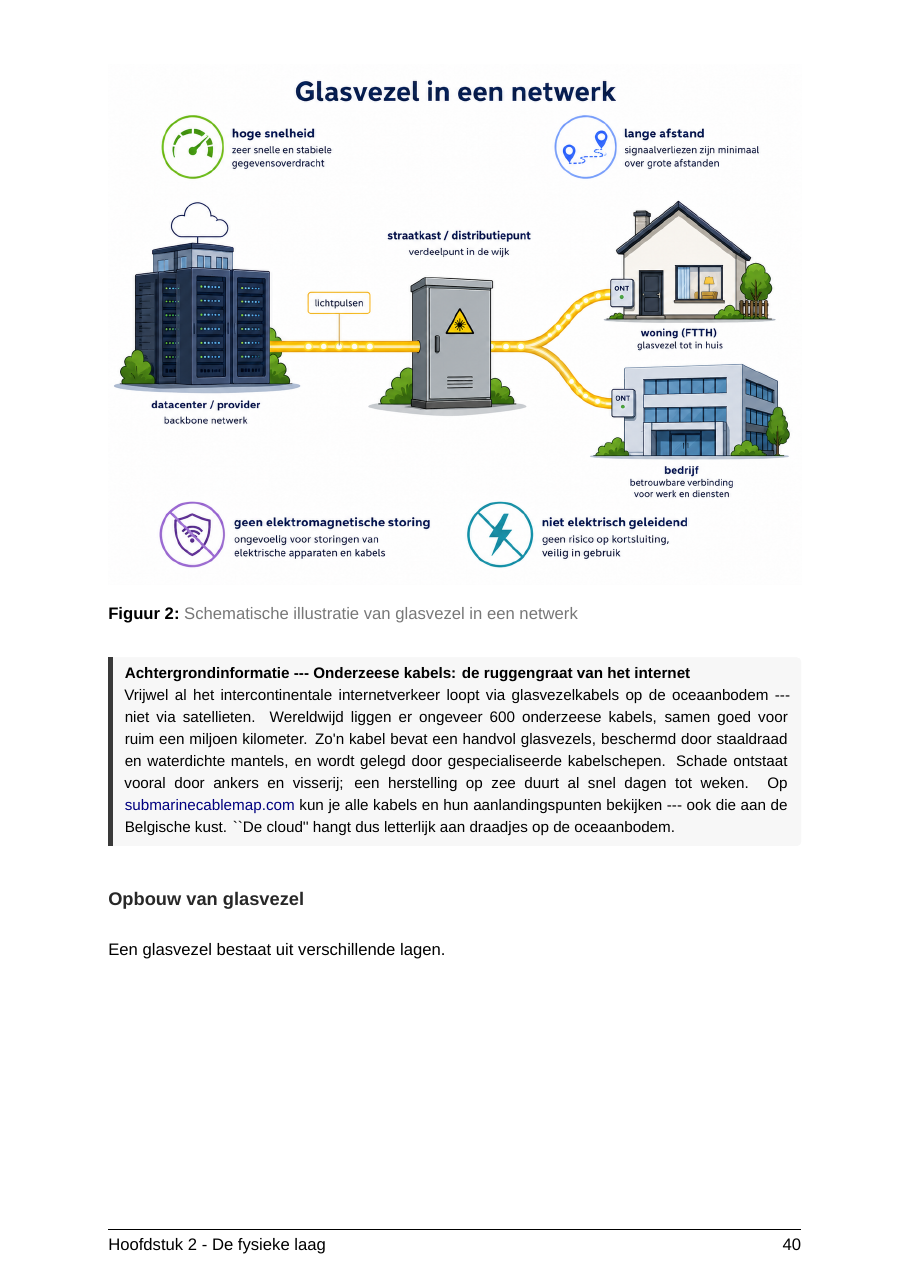
Callout-kaders
> **Achtergrondinformatie — …** in markdown wordt een grijs kader; Tip, Belangrijk, Gevaar, Praktische … krijgen elk hun kleurFiguren
zelf gegenereerde illustraties en Mermaid-diagrammen, altijd met bijschrift en nummering
Nooit copyright-materiaal
elke figuur is zelf getekend, gegenereerd of als SVG geschreven
4. Slides en huisstijl
Van boek naar 208 slides
Van boek naar slides, en terug
Boek
hoofdstuk N in
cursus-netwerken→
AI maakt deck
slides + speakernotes uit de tekst
→
boek_commit
front matter onthoudt welke boekversie gebruikt is
→
Diff
git diff <boek_commit>.. -- hs1/ → enkel wat veranderde bijwerkenHet loopt ook terug: “beetje info van slides terug naar boek duwen” — wat in het deck helderder uitgelegd was, ging als tekst terug het boek in.
Een huisstijl-sjabloon in markdown
Vroeger: inline
<div style="…"> in elke slide, telkens net anders. Nu: 17 shortcodes, één palet uit het officiële PowerPoint-sjabloon.{{< bar >}}
{{< segment color="orange" title="Header" >}}
adressen & controle-info
{{< /segment >}}
{{< segment color="teal" title="Payload" >}}
de echte inhoud, bv. `23.5°C`
{{< /segment >}}
{{< /bar >}}
De migratie: één dag, alle decks
405
shortcode-aanroepen in de zes netwerken-decks
196
cards, 79 bar-segmenten, 23 pijlen
63
losse
<img>-tags automatisch omgezet in 13 bestanden8
SVG’s vervangen door native cards/bars (subnetten, inkapseling)
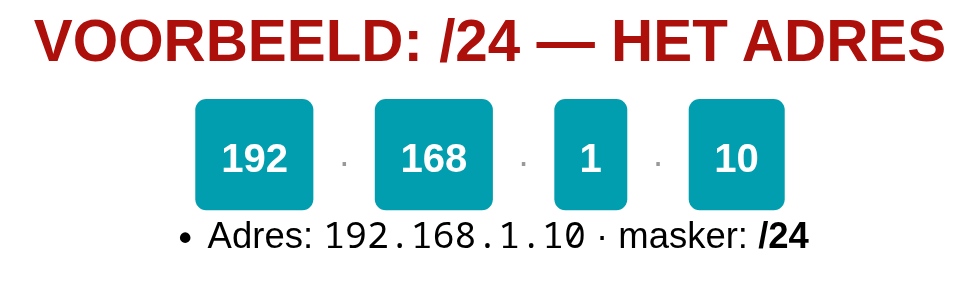
Subnet-voorbeeld uit H4: vroeger een SVG per stap, nu vier slides met cards en bars die je in markdown aanpast
Ook de publicatie is geautomatiseerd
1. Push
markdown naar GitHub
→
2. Hugo
Actions bouwt de reveal.js-site
→
3. PDF
headless Chrome maakt slides.pdf, enkel voor gewijzigde decks
↓
6. Moodle
iframe naar de live slides
←
5. Object storage
rclone –checksum synct alleen wat veranderde
←
4. Manifest
hash per deck bewaart de staat tussen runs
5. Moodle
Een cursus als build-artefact
De Moodle-cursus wordt gegenereerd
Basis-export
.mbz van de oude cursus: Algemeen, forums, vragenbank
→
transform_mbz.py
987 regels Python bouwen een nieuwe importbackup
→
validate_mbz.py
consistentiecheck vóór het uploaden
Per hoofdstuk
label met iframe naar de live slides + slides-PDF als backup
Moodle-boek
de volledige cursustekst, één boekpagina per sectie, figuren op printgrootte
Zelftest
10 automatisch verbeterde vragen per hoofdstuk, onbeperkte pogingen, feedback per vraag
Moodle’s bizarre eisen (die de AI uitzocht)
“Geen geldig Moodle back-upbestand” — twee keer, met een andere oorzaak.
Dubbele quotes
Moodle zoekt letterlijk naar
<?xml version="1.0" encoding="UTF-8"?> in de eerste 200 bytes. Python schrijft enkele quotes.Eigen tar-indeling
.ARCHIVE_INDEX als eerste entry, ustar, uid/gid 0, vaste timestamps — GNU tar wordt geweigerd.Een echte typo
veldnaam
timemcreated in mod_book is een fout in Moodle zelf, en moet dus fout blijven.6. Werkwijze en lessen
Welke AI’s deden mee?
Claude (Sonnet, Opus, Fable)
schrijven, pipeline, Moodle-tooling, slides, sjabloon — in Claude Code, rechtstreeks in de repo
GPT-5.6
PDF-export-fixes in de CI-workflow
Andere modellen
als kritische tegenlezer van het boek: verifieer elke bewering
Beeldgeneratie
illustraties zonder copyrightprobleem
27 / 81
commits in de boek-repo met een AI als expliciete co-auteur
16
co-auteur-commits in de slides-repo
Werkwijze die goed bleek te werken
Alles platte tekst
markdown in git: de AI kan lezen, diffen, herschrijven — en ik zie elke wijziging
Kleine commits
één correctie per commit, met de reden in de boodschap — deze presentatie is er letterlijk uit gereconstrueerd
Geheugen
voorkeuren blijven bewaard: “geen woordafbreking”, “laadpaal als rode draad, maar variatie”, “Claude commit, ik push”
Traceerbaar
slides kennen hun boekversie, Moodle kent zijn basis-export, README is het contract
Lessen
✅ Wat werkt
- ECTS-fiche als briefing en dekkingstabel
- eerst een ruwe versie van álles, dan verfijnen
- AI voor het saaie loodgieterswerk: LaTeX, Moodle-XML, CI
- een ander model laten tegenlezen en verifiëren
- huisstijl als herbruikbare componenten
❌ Waar opletten
- feiten klinken altijd overtuigend, ook als ze fout zijn
- globale zoek-en-vervang raakt ook commando’s
- beeldmateriaal: nooit “van het web”
- schrijven is 3 dagen, nalezen is 4 weken — plan dáárvoor
- de doelgroep en de toon blijven jouw beslissing
Conclusie: wat heeft het gekost?
≈ 160 u
naar schatting, over vijf weken
≈ 10 %
van een voltijds jaar — voor boek, slides, pipeline én Moodle
≈ € 100
per maand — AI-abonnement (Claude Max, voor Claude Code)
niet klaar
Wireshark-screenshots, pcap-oefening, slides H7–H8, tweede leesronde
AI haalt het schrijven en het loodgieterswerk weg. Wat overblijft — lezen, verifiëren, kiezen — is nog altijd werk, maar het is het werk van een lector, niet van een typist.
En nu?
sep 2026
lesgeven met het materiaal zoals het nu is: slides, PDF, zelftests
sem. 1
boek als Moodle-boek op Digitap, per hoofdstuk naast de slides
jan 2027
grondige update na het semester: studentenfeedback, H7/H8-slides, open punten
voorjaar 2027
mogelijk het boek uitgeven — de B5-versie ligt al klaar
Dankzij de pipeline is elke stap één commando: markdown aanpassen, en PDF, slides én Moodle-import komen opnieuw uit dezelfde bron.
Wat ik nog zoek: ideeën vangen onderweg
Het probleem
de beste ideeën komen in de auto en op de fiets — de slide “wat heeft het gekost” is er net zo eentje
Wat ik probeerde
Gemini die naar Google Keep dicteert: werkt een beetje, maar de structuur ontbreekt en het blijft losse notities
Wat ik wil
handsfree, zonder verkeersregels te schenden, en meteen gestructureerd: bij het juiste hoofdstuk, als todo of als vraag
Tips welkom. Ideaal: spreken onderweg, en aan de laptop ligt er een geordend lijstje klaar in de repo — of nog beter, een kant-en-klare git-commit.